 SEO
SEO
À quoi sert le fichier robots.txt ?
Il dit où les moteurs peuvent aller, pas ce qu’ils peuvent afficher. Confondre les deux fait disparaître des pages, ou en révèle qu’on voulait cacher.
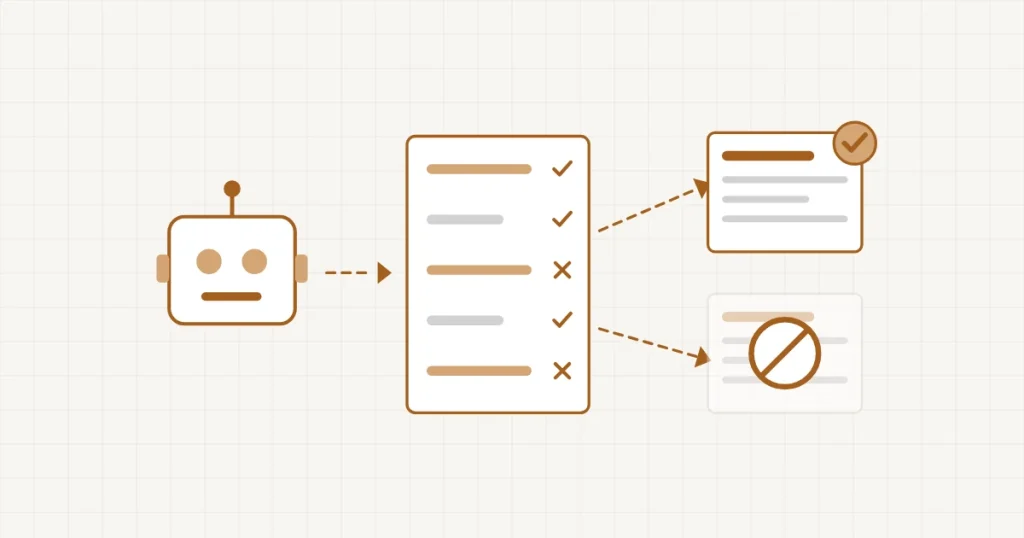
C’est un fichier texte de quelques lignes, posé à la racine du site, que tout moteur consulte avant de l’explorer. Sa simplicité est trompeuse : mal écrit, il peut retirer un site entier des résultats.
Ce qu’il fait, et ce qu’il ne fait pas
Il indique les zones où l’exploration n’est pas souhaitée. C’est tout. Il ne protège rien, il ne cache rien, et il ne retire pas une page des résultats de recherche.
La nuance est décisive. Une page bloquée dans ce fichier peut parfaitement apparaître dans les résultats, sans description, si un autre site pointe vers elle. Le moteur sait qu’elle existe, il n’a simplement pas le droit d’aller la lire.
Pour retirer une page des résultats, il faut au contraire laisser le moteur y accéder, afin qu’il y lise la directive de non‑indexation.
L’erreur qui coûte le plus cher
Bloquer une page pour l’empêcher d’apparaître. Le moteur ne peut alors plus lire la directive de non‑indexation qu’elle contient, et l’adresse reste dans l’index, sans texte, indéfiniment.
L’autre erreur classique est le blocage total, oublié après une refonte. Deux lignes, et le site entier devient inexplorable. Cela se voit en quelques jours dans les statistiques, et c’est souvent diagnostiqué comme une pénalité alors que c’est une porte fermée.
Que bloquer, concrètement ?
- Les zones d’administration et les espaces de connexion.
- Les résultats de recherche interne, qui fabriquent une infinité d’adresses sans valeur.
- Les paniers et tunnels de commande, qui n’ont aucune raison d’être explorés.
- Rien d’autre, en général. Un fichier de cinq lignes couvre le besoin d’un site d’entreprise.
Et surtout : ne jamais bloquer les feuilles de style ni les scripts. Un moteur qui ne peut pas les charger voit une page cassée, et juge en conséquence.
Comment vérifier le mien ?
Ajoutez /robots.txt à votre adresse : le fichier s’affiche dans le navigateur. S’il contient une interdiction générale, votre site n’est pas exploré, et c’est le premier point à corriger avant toute autre action de référencement.
Sur une installation qui n’a pas de fichier réel, WordPress en produit un automatiquement. Il convient très bien tel quel, à condition que la case « demander aux moteurs de ne pas indexer » soit décochée.
Sur le même sujet : Peut‑on être référencé sans écrire d’articles ? · Une page ou un article : quelle différence ?
Cette question vous concerne ?
Décrivez‑moi votre situation en deux lignes. Je vous donne mon avis, sans engagement.
Réponse sous 24 h · Premier échange offert